Claude CodeやCursorなどのAIコーディングエージェントを使っていて、「すぐにコンテキストがいっぱいになる」「トークンの消費が多い」と感じたことはありませんか?
その原因の多くは、エージェントがコードを探すときの動き方にあります。Sembleは、この「コード探し」で消費するトークンを大幅に減らすための、AIエージェント向けのコード検索ライブラリです。
結論:Sembleで得られる3つのメリット
先に結論からお伝えします。Sembleを導入すると、次の3つのメリットがあります。
- トークン消費を約99%削減:エージェントがコードを探すときに使うトークン量が、grep+ファイル読み込みに比べて平均で約99%少なくなります
- 少ないトークンで目的のコードにたどり着ける:約2,000トークンで探したいコードの97%を見つけられます。grep+ファイル読み込みでは約100,000トークンを使っても85%にとどまります
- 無料・ローカル・2コマンドで導入:MITライセンスのオープンソースで、CPUだけで動きます。APIキーやGPU、外部サービスは不要で、導入は2つのコマンドで完了します
※リコールは「探したいコードをどれだけ見つけられたか」の割合です。数値は開発元の公式ベンチマークによるもので、実際の削減率はリポジトリや使い方によって変わります。記載内容は執筆時点(2026年9月、Semble v0.6.1)の公式GitHubリポジトリ(MinishLab/semble)の情報に基づいています。
なぜAIエージェントはトークンを大量に消費するのか?
AIエージェントにコードを調べさせると、多くの場合、grep(文字列検索)で候補のファイルを探し、ヒットしたファイルを丸ごと読み込みます。本当に必要なのが数十行だけでも、ファイル全体がコンテキストに入ってしまいます。目的のコードでなければ、別のファイルを探して読み込む、という動きを繰り返します。
Sembleを使うと、エージェントは自然言語で質問するだけで、関連するコード断片だけを受け取れます。ファイル全体を読み込む必要がないため、消費するトークンが大きく減ります。
Sembleとは?基本情報
Sembleは、Model2Vecなどを手がけるMinishLabが開発し、GitHubのMinishLab/sembleで公開しているPythonライブラリです。ライセンスはMITで、無料で使えます。
ひとことで言えば、AIエージェント専用の検索エンジンです。Semble自体はAIサービスではなく、手元のPCのCPU上で動く検索ツールなので、コードを外部に送信する必要はありません。
対応するエージェントとして、Claude Code、Cursor、Codex、OpenCode、VS Codeなどが挙げられており、MCPに対応したエージェントであれば基本的に利用できます。
主な特徴
- 高速:平均的なリポジトリを約500ミリ秒でインデックス化し、検索には約1ミリ秒で応答します(すべてCPU上)
- 高精度:公式ベンチマークでNDCG@10(検索結果上位10件の質を表す指標)が0.854です。コード特化型のAIモデル「CodeRankEmbed」(1億3,700万パラメータ)と同等の検索品質で、インデックス作成は約380倍、検索は約17倍高速です
- セットアップ不要:APIキー、GPU、外部サービスは必要ありません
- ローカル・リモート両対応:ローカルのフォルダだけでなく、gitのURLを指定して検索することもできます。複数のリポジトリをまとめて検索することも可能です
仕組み:なぜ速くて正確なのか
Sembleは、コードを関数やクラスなどの単位に区切り、2種類の検索を組み合わせて結果を返します。
意味が近いコードを探す
関数名・API名の一致に強い
- 意味検索:コード特化の埋め込みモデル「potion-code-16M-v2」(Model2Vec)を使い、「意味が近いコード」を探します
- キーワード検索(BM25):関数名やAPI名など、識別子の一致に強い検索です
埋め込みモデルが「静的」で、検索のたびに重いAIモデルの計算をしないため、CPUだけでもミリ秒単位で検索できます。一度作ったインデックスはキャッシュされ、ファイルが変更されたときは変わった部分だけが更新されます。
Sembleの導入方法
導入は、次の4ステップで完了します。
uv tool install semble
semble install
MCPサーバーInstructionsサブエージェント
対話型インストーラーで導入する(おすすめ)
Pythonのパッケージ管理ツール「uv」をインストールしたうえで、ターミナルで次のコマンドを実行します。
uv tool install semble
semble install
semble installを実行すると、Claude Code・Codex・OpenCodeなど、インストール済みのコーディングエージェントが自動で検出されます。続けて、有効にする連携方法を選びます。
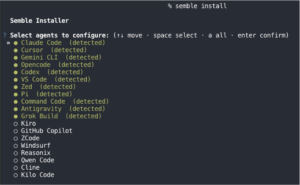
| 連携方法 | できること |
|---|---|
| MCPサーバー | エージェントがSembleをツールとして直接呼び出せるようになる |
| Instructions | AGENTS.md / CLAUDE.mdに、SembleのCLIの使い方を追記する |
| サブエージェント | コード検索専用のsemble-searchサブエージェントを追加する |
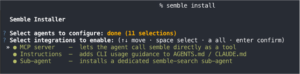
設定を元に戻したいときはsemble uninstallを実行します。
対話なしでインストールする
サンドボックス環境やスクリプトから導入する場合は、エージェントと連携方法をオプションで指定すれば、確認プロンプトを省略できます。
semble install --agent claude --type mcp subagent --yes
--typeにはmcp、instructions、subagent、all(デフォルト)を指定できます。
アップデート方法と初回利用時の注意
アップデートはuv tool upgrade sembleで行います。MCPサーバーとして使っている場合は、続けてuv cache clean sembleを実行し、MCPクライアント(エージェント)を再起動してください。
なお、初回利用時には埋め込みモデルがHugging Faceからダウンロードされます。ネットワーク接続が必要なのはこの1回だけです。
Sembleの基本的な使い方
エージェントから使う(MCPサーバー)
MCPサーバーとして連携すると、エージェントは次の2つのツールを使えるようになります。
| ツール | できること |
|---|---|
search |
自然言語またはコードでコードベースを検索する。repoにローカルパスやgitのURL、contentに検索対象の種類を指定できる |
find_related |
ファイルパスと行番号を指定し、その位置のコードと意味が近いコードを探す |
効果を最大にするコツは、エージェントに「grepで探す前に、まずSembleのsearchを使う」と指示しておくことです。ファイル全体を読み込む回数が減り、トークンとコンテキストの消費を抑えられます。semble installで「Instructions」を選ぶと、この指示がAGENTS.md / CLAUDE.mdに追記されます。
CLIで使う
SembleはCLIツールとして単体でも使えます。インデックスは初回の検索時に自動で作成・キャッシュされます。
# ローカルのリポジトリを自然言語で検索
semble search "authentication flow" ./my-project

# リモートのリポジトリを検索(必要に応じてクローンされる)
semble search "save model to disk" https://github.com/MinishLab/model2vec

# 複数のリポジトリをまとめて検索
semble search "invoice endpoint" ./service-a ./service-b

# 取得件数を指定
semble search "save model to disk" ./my-project --top-k 10

# コード以外(ドキュメント)を検索
semble search "deployment guide" ./my-project --content docs

# 指定した位置のコードに似たコードを探す
semble find-related src/auth.py 42 ./my-project
主なオプションは次のとおりです。
--content:検索対象。code(デフォルト)、docs、config、all--format:出力形式。json(デフォルト)かtext--max-snippet-lines:結果ごとに表示するコードの行数(0ならファイルパスと行番号だけ)
検索対象を調整する
Sembleは.gitignoreと.sembleignoreを読んで、インデックスの対象を決めます。.sembleignoreを使えば、.gitignoreを変えずにSemble専用のルールを追加できます。node_modules/や.venv/、dist/などの一般的なディレクトリは自動で除外されます。
# .sembleignore
generated/     # 生成コードを除外
!*.proto       # デフォルトでは対象外の拡張子を追加
削減できたトークン量を確認する
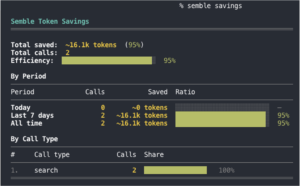
semble savingsを実行すると、これまでの検索で削減できたトークン数の推計を、期間別・呼び出しの種類別に確認できます。公式READMEに掲載されている出力例では、削減率は約94%でした。
semble savings
削減量は「結果を返したファイル全体の文字数 − 実際に返したコード断片の文字数」を4文字=1トークンとして換算した推計値です。「ファイルを丸ごと読んだ場合」と比べた、控えめな見積もりとされています。
Pythonライブラリとして使う
独自のツールに検索機能を組み込みたい場合は、Pythonから直接呼び出すこともできます。
from semble import SembleIndex

index = SembleIndex.from_path("./my-project")
results = index.search("save model to disk", top_k=3)
print(results[0].chunk.file_path, results[0].chunk.start_line)
Sembleとgrepの使い分け
Sembleを入れても、grepが不要になるわけではありません。目的に応じて使い分けるのがおすすめです。
| やりたいこと | おすすめの方法 |
|---|---|
| 「〇〇の処理はどこ?」と機能や意味で探したい | Sembleのsearch |
| 見つけたコードと似た実装を探したい | Sembleのfind_related |
| ドキュメントや設定ファイルを探したい | Sembleのsearch(--content docs / config) |
| 特定の文字列の出現箇所をすべて洗い出したい | grep |
Sembleのメリット・デメリット
メリット
- トークンとコンテキストの節約:必要なコード断片だけを返すため、エージェントがファイルを丸ごと読む回数が減ります
- ローカルで完結:CPUだけで動き、コードを外部サービスに送る必要がありません
- 導入が簡単:
uv tool install sembleとsemble installの2コマンドで主要なエージェントと連携できます - 無料で使える:MITライセンスのオープンソースです
デメリット・注意点
- 開発者向けのツール:AIコーディングエージェントを使わない人にはメリットが少ないです
- 初回はモデルのダウンロードが必要:オフライン環境では、事前にモデルを用意して環境変数
SEMBLE_MODEL_NAMEで指定する必要があります - 大きなファイルは対象外:1MBを超えるファイルはデフォルトでインデックス化されません(
SEMBLE_MAX_FILE_BYTESで変更できます) - 完全一致の網羅には不向き:特定の文字列をすべて洗い出す用途では、grepを併用したほうが確実です
まとめ
Sembleは、AIコーディングエージェントのコード探しで消費するトークンを大幅に減らせる、無料のコード検索ライブラリです。
- grep+ファイル読み込みに比べて、トークン消費を平均で約99%削減(公式ベンチマーク)
- 約2,000トークンでリコール97%と、少ないトークンで目的のコードにたどり着ける
- CPUだけで動き、APIキー・GPU・外部サービスは不要。MITライセンスで無料
- 導入は
uv tool install sembleとsemble installの2コマンド - エージェントには「grepより先にSembleの
searchを使う」と指示しておくと効果的 semble savingsで、実際に削減できたトークン量を確認できる
まずは手元のリポジトリでsemble searchを試し、エージェントに組み込んだあとはsemble savingsで効果を確かめてみてください。
コメント